勘で直していた音声と文字の配置を、定量的に採点できるようにする
先生がドラッグで直した値を正解データにして、調節アルゴリズムを直すたびにms単位で自動採点するハーネスを作りました。 このループで文字の開始点ずれを26件から2件まで減らし、母音の無声化のような言語特性の処理まで見つけた記録です。
韓国語を学ぶ日本人と日本語を学ぶ韓国人のための発音矯正サービスを開発・運営しています。学習者の録音はイントネーション(ピッチ)曲線の上に文字を載せた「フィードバックカード」になり、ネイティブの先生がその上に添削して返します。このフィードバックカードの自動生成を検証する社内レビューツールを作りながら、最初にぶつかったのは評価の問題でした。音声と文章を入れるとピッチ曲線の上に音節とモーラ(拍)を自動配置したカードが生成されるのですが、この配置が「合っているか」を判定する基準がありませんでした。誤差を減らしたと言うには、比べる基準が先に必要でした。
正解データはサービスの構造の中にすでにありました。自動配置は下書きで、先生がドラッグで補正して完成版を作る構造だったのですが、そのドラッグ補正値こそネイティブが耳で判定した正解でした。この補正データを正解に昇格させ、アライメントアルゴリズムのあらゆる変更をms単位で採点するハーネス(修正のたびに正解と比べて自動で点数を出す採点装置)を作りました。この時から「この修正は良くなったのか?」は勘ではなく数字で答えられる質問になりました。このハーネスで検証して採用した改善(単語境界の有声スナップ、エネルギーブラケットのトリミング)が、アライメント誤差p90を323msから212msへ34%削減しました。
ハーネスはOK判定と同じくらい、NG判定でも働きました。文全体の無音区間を切り落とすエネルギートリミングは、文末の息の音ひとつで内部の配置が押しつぶされ、誤差を45msから66msに広げました。エネルギーピークで音節を分ける方式は52msを167msにしました。どちらも見た目にはもっともらしかったのですが、採点の点数が悪化したためNGとし、本番には入れていません。
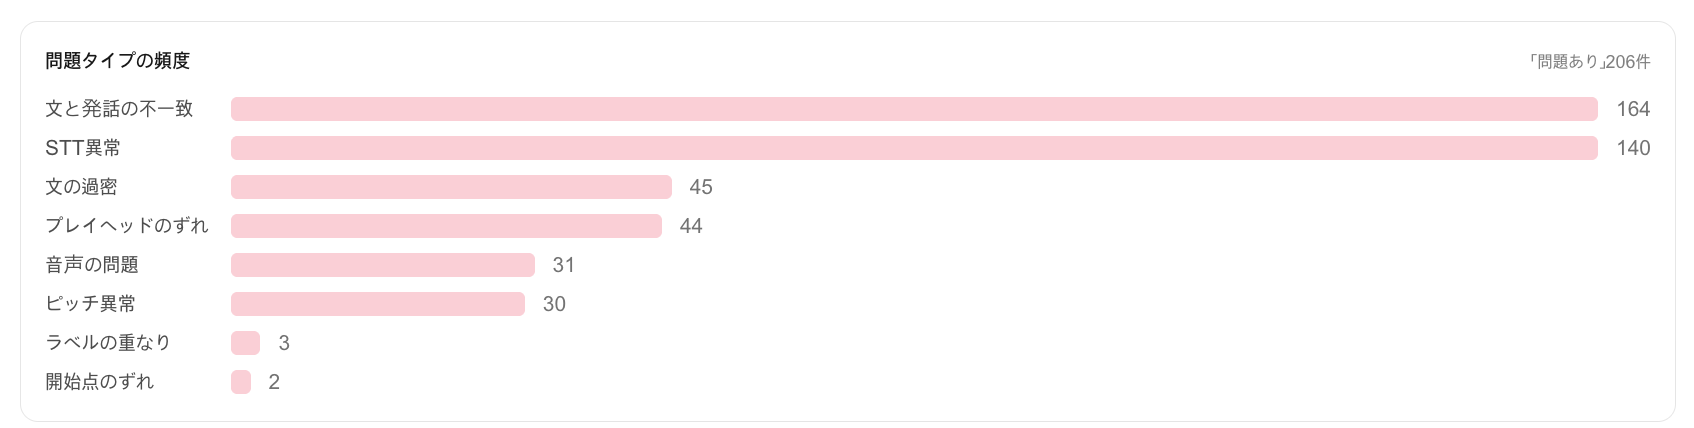
ハーネスが機械採点なら、レビューラウンドは人間による採点です。韓国語と日本語のネイティブの先生2名とカード243件(日本語173、韓国語70)のレビューラウンドを回しました。指摘は自由記述のままではなく、問題タイプに分類して集計しました。自動認識のずれ、文章と発話の不一致、文字の過密、ピッチ表示の誤り、録音の欠陥、再生位置のずれ。6タイプに分けると、非開発者の「なんか変です」がラウンドごとに比較可能なエンジニアリング指標になりました。
v1にもあった韓国語サンプル58件基準で、1次と2次ラウンドの間の変化はこうです。
| 問題タイプ | v1 | v2 |
|---|---|---|
| 文字開始点のずれ | 26件 | 2件 |
| 音声自動認識の誤り | 21件 | 0件 |
| ピッチ表示の誤り | 12件 | 2件 |
| 再生位置のずれ | 32件 | 25件 (未解決、次の最優先課題) |
未解決の項目も表にそのまま残しました。できていないことがどこにどれだけ残っているかが、そのまま次のラウンドの作業リストになるからです。
このループから生まれた最も大きな決定は、評価基準の見直しでした。カードのテキスト基準はもともとSTT(Whisper)の認識結果でした。単語タイムスタンプをアライメントのシードに使っていたので、認識結果を基準にするのが自然に見えました。
ところがレビューの集計で、自動認識のずれが日本語カードだけで140件と最多タイプであり、原文と突き合わせると原文ベースのアライメントの方が一貫して正確でした。そこで基準をひっくり返しました。原文がカードの基準になり、AI認識結果はオプション表示に降格。STTは時間情報を与えるシードとしてだけ残りました。AI機能を増やすことより、どこまで信じるかを実測で決めることの方が品質に貢献しました。
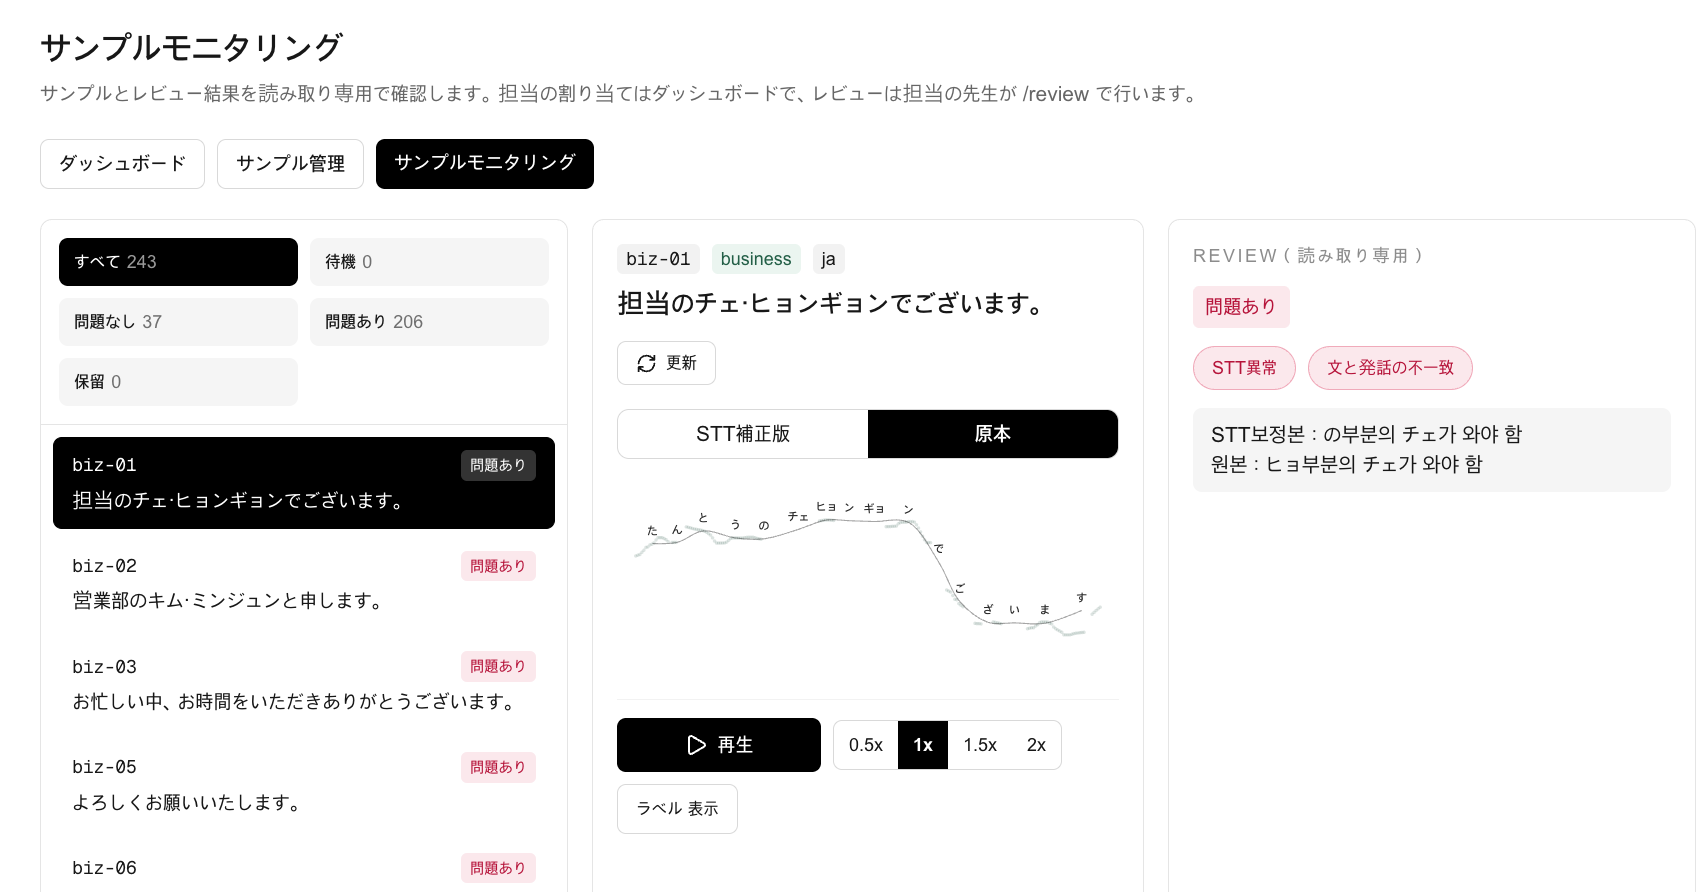
タイプ分類で明らかになった日本語特有の問題は、カードが実際の音より先に終わる現象でした。ですで終わる文章で、カードの最後のモーラが実際の発話より先に閉じるパターンが繰り返されていました。
原因は母音の無声化でした。日本語では、ですの「す」のようなモーラは母音が無声化し、声帯が振動しません。ピッチは声帯の振動から生まれるため無声区間にはピッチがなく、アライメントパイプラインはこの区間を発話が終わったものとして切り捨てていました。音のないモーラも発話時間を占めるため、日本語の文末に限り有声区間が終わった後も最大0.3秒までを発話区間として認めるように直しました。同じ脈略を韓国語に適用すると、文末がたいてい有声母音のため延長分が息や残響を拾い、アライメント誤差が92msから133msへ悪化することが実測で確認されたので、このルールは日本語専用にしています。
// 文末の無声尾を発話区間として認める最大長 (秒)
export const UNVOICED_TAIL_MAX_SEC = 0.3

// 言語別の無声尾の許容値 (日本語のみ > 0)
export const unvoicedTailSecFor = (lang?: PitchLang): number => {
  if (lang === 'ja') return UNVOICED_TAIL_MAX_SEC

  return 0
}
この修正でカードの終わりと耳に聞こえる終わりが一致しました。この問題を見つけたのは先生のレビューでした。自動ベンチマークでは検出できないタイプです。
レビューループは、コードでは直せない問題を選り分ける効果もありました。録音の欠陥31件(話した内容の一部が録音に存在しない、あるいは文末が切れているカード)は、どんなアライメントアルゴリズムでも直せません。この項目は修正タスクではなく、再録音するかどうかという運営の意思決定事項に分類して運営メンバーに渡しました。
再生位置のずれ25件が次のラウンドの最優先課題として残っています。レビューツールで検証された改善は、学習者向けサービスのフィードバックカードのレンダリングにも同じく反映され、デプロイ済みです。アルゴリズムはこれからも変わるでしょうが、変わるたびにハーネスがms単位で採点し、次のレビューラウンドが人間の耳で再判定するループはそのまま維持されます。