감으로 고치던 음성과 글자 배치, 채점 가능하게 만들기
선생님이 드래그로 고친 값을 정답 데이터로 삼아, 정렬 알고리즘을 고칠 때마다 ms 단위로 자동 채점하는 하네스를 만들었습니다. 이 루프로 글자 시작점 밀림을 26건에서 2건까지 줄이고, 모음 무성화 같은 언어 특성 처리까지 찾아낸 기록입니다.
일본어를 배우는 한국인과 한국어를 배우는 일본인을 위한 발음 교정 서비스를 만들어 운영하고 있습니다. 학습자의 녹음은 억양(피치) 곡선 위에 글자를 얹은 "피드백 카드"가 되고, 원어민 선생님이 그 위에 첨삭해 돌려줍니다. 이 피드백 카드의 자동 생성을 검증하는 내부 검수 툴을 만들면서 가장 먼저 부딪힌 문제는 평가였습니다. 음성과 문장을 넣으면 피치 곡선 위에 음절과 모라(일본어에서 한 박자로 세는 소리 단위. 대체로 가나 한 글자가 한 박자)를 자동 배치하는 카드가 나오는데, 이 배치가 "맞았는지"를 판정할 기준이 없었습니다. 오차를 줄였다고 말하려면 비교할 기준이 먼저 필요했습니다.
정답 데이터는 서비스 구조 안에 이미 있었습니다. 자동 배치는 초안이고 선생님이 드래그로 보정해 완성본을 만드는 구조였는데, 그 드래그 보정값이 곧 원어민이 귀로 판정한 정답이었습니다. 이 보정 데이터를 정답으로 승격시키고, 정렬 알고리즘의 모든 변경을 ms 단위로 채점하는 하네스(harness, 수정할 때마다 정답과 비교해 자동으로 점수를 내는 채점 장치)를 만들었습니다. 이때부터 "이 수정이 나아졌나?"는 감이 아니라 숫자로 답할 수 있는 질문이 됐습니다. 이 하네스로 단어 경계 유성 스냅과 에너지 브래킷 트리밍을 채택했고, 정렬 오차 p90이 323ms에서 212ms로 34% 줄었습니다.
하네스는 채택만큼 기각으로도 일했습니다. 문장 전체의 무음 구간을 잘라내는 에너지 트리밍은 문장 끝 숨소리 하나에 내부 배치가 압착돼 오차를 45ms에서 66ms로 키웠고, 에너지 피크로 음절을 나누는 방식은 52ms를 167ms로 만들었습니다. 둘 다 눈으로 보기엔 그럴듯했지만 채점 점수가 나빠져 기각했고, 프로덕션에는 들어가지 못했습니다.
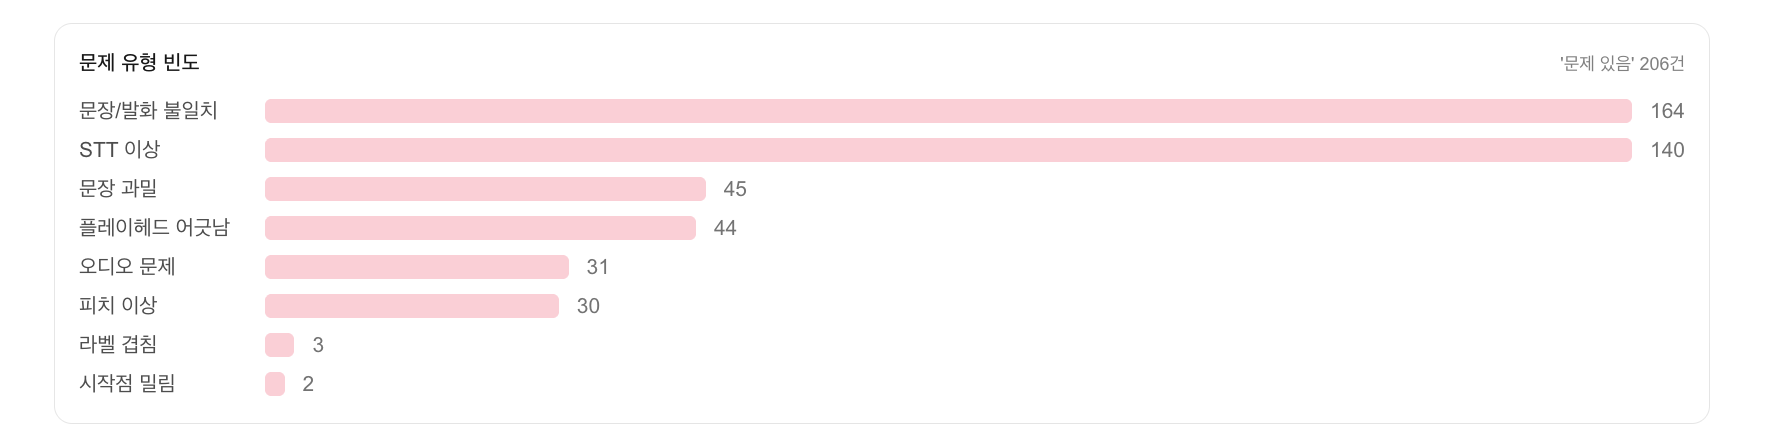
하네스가 기계 채점이라면, 검수 라운드는 사람 채점입니다. 한국어와 일본어 원어민 선생님 두 분과 카드 243건(일본어 173, 한국어 70)을 놓고 검수 라운드를 돌렸습니다. 지적은 자유 서술 대신 문제 유형으로 분류해 집계했습니다. 자동 인식 어긋남, 문장과 발화의 불일치, 글자 과밀, 음높이 표시 오류, 녹음 결함, 재생 위치 어긋남. 여섯 유형으로 나누자 비개발자의 "뭔가 이상해요"가 라운드마다 비교 가능한 엔지니어링 지표가 됐습니다.
v1에도 있던 한국어 샘플 58건 기준으로, 1차와 2차 라운드 사이의 변화는 이렇습니다.
| 문제 유형 | v1 | v2 |
|---|---|---|
| 글자 시작점 밀림 | 26건 | 2건 |
| 음성 자동 인식 오류 | 21건 | 0건 |
| 음높이 표시 오류 | 12건 | 2건 |
| 재생 위치 어긋남 | 32건 | 25건 (미해결, 차기 1순위) |
미해결 항목도 표에 그대로 남겼습니다. 안 된 것이 어디에 얼마나 남았는지가 그대로 다음 라운드의 작업 목록이 되기 때문입니다.
이 루프에서 나온 가장 큰 결정은 기준 교체였습니다. 카드의 텍스트 기준은 원래 STT(Whisper)의 인식 결과였습니다. 단어 타임스탬프를 정렬의 시드로 쓰고 있었으니 인식 결과를 기준으로 삼는 게 자연스러워 보였습니다.
그런데 검수 집계에서 자동 인식 어긋남이 일본어 카드에서만 140건으로 최다 유형이었고, 원본 문장과 대조해보니 원본 정렬이 일관되게 더 정확했습니다. 그래서 기준을 뒤집었습니다. 원본 문장이 카드의 기준이 되고, AI 인식 결과는 선택적 표시로 내려갔습니다. STT는 시간 정보를 주는 시드로만 남았습니다. AI 기능을 늘리는 것보다 어디까지 믿을지를 측정으로 정하는 쪽이 품질에 기여했습니다.
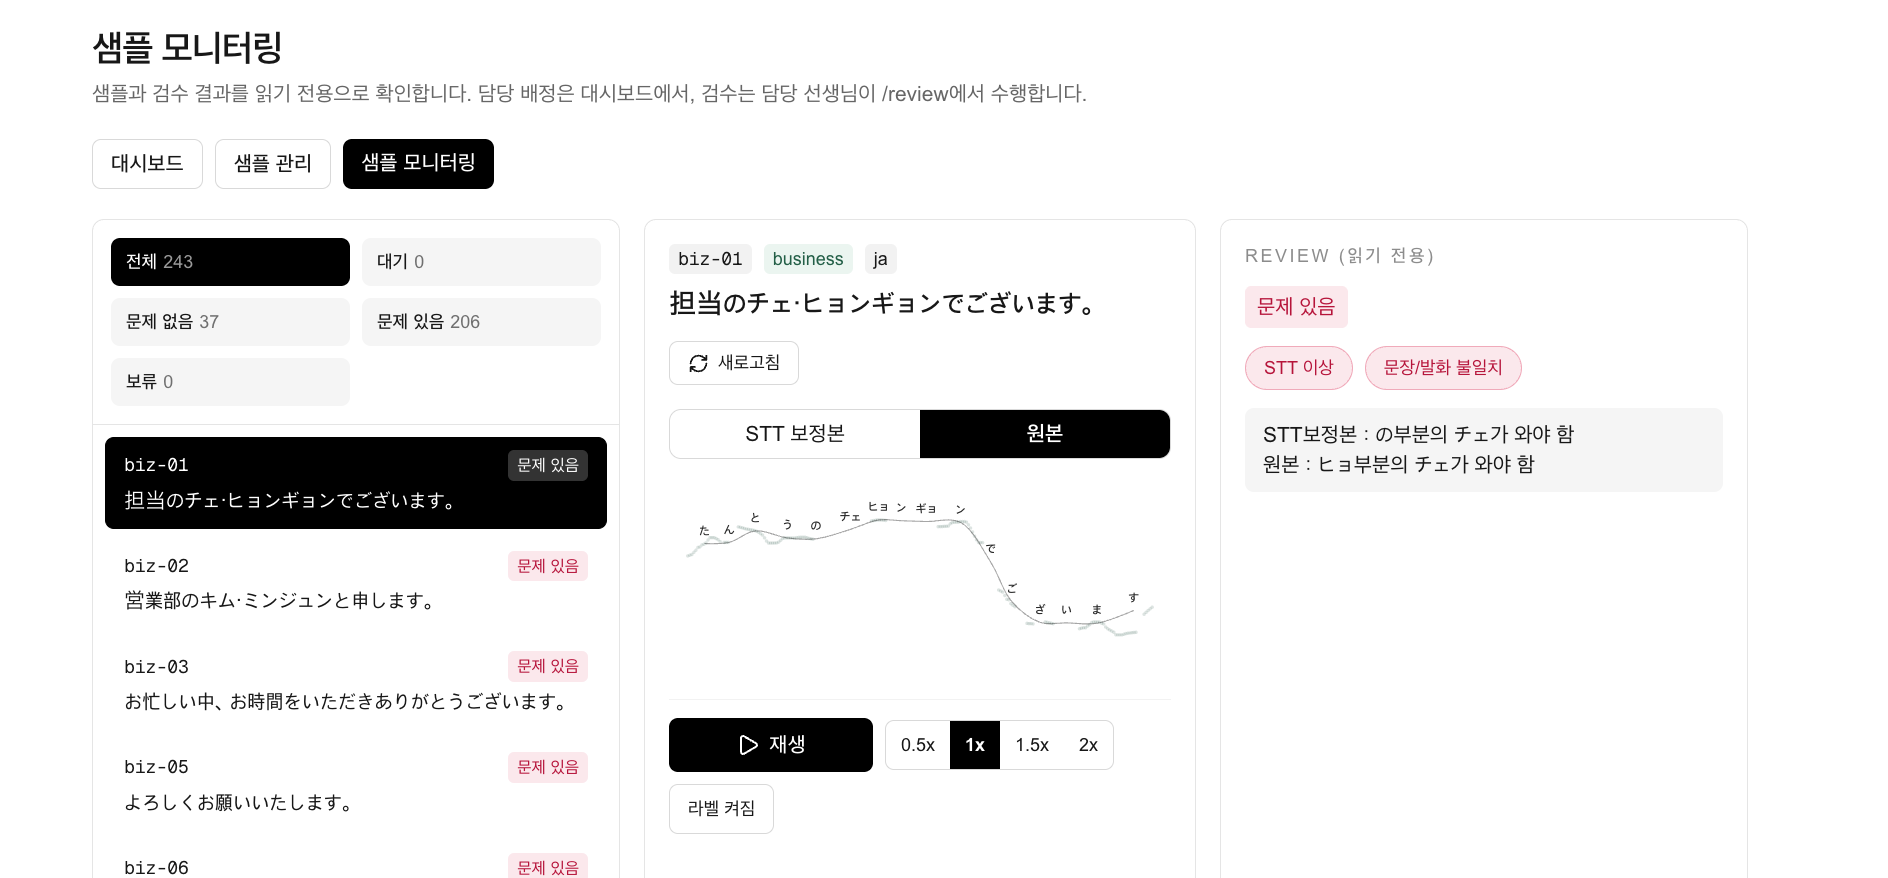
유형 분류로 드러난 일본어 특유의 문제는 카드가 실제 소리보다 일찍 끝나는 현상이었습니다. です로 끝나는 문장에서 카드의 마지막 모라가 실제 발화보다 앞서 닫히는 패턴이 반복됐습니다.
원인은 모음의 무성화였습니다. 일본어에서 です의 す 같은 모라는 모음이 무성화되어 성대가 울리지 않습니다. 피치는 성대 진동에서 나오므로 무성 구간에는 피치가 없고, 정렬 파이프라인은 이 구간을 발화가 끝난 것으로 처리해 잘라내고 있었습니다. 소리 없는 모라도 발화 시간을 차지하므로, 일본어 문장 끝에 한해 유성 구간이 끝난 뒤에도 최대 0.3초까지를 발화 구간으로 인정하도록 고쳤습니다. 같은 연장을 한국어에 적용하면 문장 끝이 대개 유성 모음이라 연장분이 숨과 잔향을 먹어 정렬 오차가 92ms에서 133ms로 오히려 나빠지는 것이 실측으로 확인돼, 이 규칙은 일본어 전용으로 남겼습니다.
// 문장 끝 무성 꼬리를 발화 구간으로 인정하는 최대 길이 (초)
export const UNVOICED_TAIL_MAX_SEC = 0.3

// 언어별 무성 꼬리 허용치 (일본어만 > 0)
export const unvoicedTailSecFor = (lang?: PitchLang): number => {
  if (lang === 'ja') return UNVOICED_TAIL_MAX_SEC

  return 0
}
이 수정으로 카드의 끝과 귀에 들리는 끝이 일치했습니다. 이 문제를 찾아낸 것은 선생님의 검수 지적이었습니다. 자동 벤치마크에는 잡히지 않는 유형입니다.
검수 루프는 코드로 고칠 수 없는 문제를 가려내는 데도 쓰였습니다. 녹음 결함 31건(말한 내용 일부가 녹음에 아예 없거나 문장 끝이 잘린 카드)은 어떤 정렬 알고리즘으로도 고칠 수 없습니다. 이 항목은 수정 과제가 아니라 재녹음 여부라는 운영 결정 사항으로 분류해 운영진에게 넘겼습니다.
재생 위치 어긋남 25건이 다음 라운드의 1순위로 남아 있습니다. 검수 툴에서 검증된 개선은 학생용 서비스의 피드백 카드 렌더링에 동일하게 반영되어 배포됐습니다. 알고리즘은 계속 바뀌겠지만, 바뀔 때마다 하네스가 ms 단위로 채점하고 다음 검수 라운드가 사람의 귀로 재판정하는 루프는 그대로 유지됩니다.